Haiku 5.5 是我目前有實際使用在 AI 工作流的大語言模型,因為它的 CP 值還算真的滿高的。
做一些比較簡單的動作、一些比較自動化的操作動作,或者是要請它判斷一些文意的話,我都會交給 Haiku 5.5。
找同一批檔案,Haiku 花的錢少了很多
請 AI 找出,如果要新增一個功能會修改哪些程式檔案,結果 Haiku 和 Opus 交回的清單差不多,但是費用卻差了十幾倍?
Reddit 有位使用者把專案中的 6 項工作交給不同 Claude 模型後,得到這樣的結果。
他平常在 Claude Code 裡工作,這次拿出 Opus 已經完成的任務,讓 Sonnet 和 Haiku 使用相同提示與檔案重新做,再核對各自的結果。
其中找檔案這一題,新增功能實際需要修改 48 個檔案,Haiku 5.5 和 Sonnet 5.5 都找到 44 個,Opus 5.5 找到 45 個。
3 個模型都設為 High,使用相同提示與檔案,Haiku 花了約 0.44 美元,Sonnet 約 1.38 美元,Opus 約 6.17 美元。
如果每天都有這種工作,累積下來就會是一筆差得不少的費用。
不過,他另外請模型查一個運動聯盟的當季規則時,Haiku 沒能開啟官方規則的 PDF,竟然改用上一季的資料。
省下費用之後,拿到的答案能不能用,才是接下來要看的事。
Anthropic 在 10 月 7 日正式推出 Haiku 5.5,已開放透過 Claude Platform、Claude Code 及主要雲端平台使用。
這次它還能調整 effort,也就是讓模型投入多少思考;同一個 Haiku,調成 Medium、High 或 Max,花費和結果都可能不同。
因此,要判斷它值不值得用,得把工作內容、推理設定和實際交回的成果放在一起看。
找檔案很接近,查資料卻拉開了差距
前面那位 Reddit 使用者挑出的 6 項工作,除了找程式檔案,還有 3 項網路研究,以及 2 篇部落格文章發布前的事實查核。
做網路研究時,他請模型查運動聯盟的規則和 Google Play 帳號規定,再用聯盟官方文件與 Google 說明頁核對答案。
例如 Google Play 這一題,他列出 12 個要點作為答案,Haiku 答對 5 個,Opus 則答對 12 個。
另外 2 項工作,是請模型檢查準備發布的部落格文章,找出內容中的事實錯誤。
Haiku 雖然找到 4 處真正的錯誤,卻也把 30 處原本正確的內容標成錯誤。
這就很麻煩了:如果直接照著改,原本寫對的地方反而會被改錯。
原作者在同一篇討論的追加回覆裡,又把 Haiku 提高到 Xhigh,重做相同的 6 項工作,看看增加思考能不能改善結果。
這次 Haiku 讀到了官方規則,研究結果也有改善,但文章查核仍把 28 處正確內容判成錯誤。
在這輪的 5 項網路工作,也就是 3 項研究加上 2 項文章查核中,Haiku 花了約 2.28 美元、34 分鐘,Opus High 則約 4.81 美元、16 分鐘。
Haiku 的帳單仍然較低,但等得更久,交回的查核結果也還需要逐項確認。
原作者在原貼交代的分工,是保留 Haiku 做程式碼搜尋,研究與事實查核則交給 Opus。
同一組工作裡,找檔案可以對照清單,查規則要確認是否用了當季文件,文章查核則要分清真正的錯誤和誤判,光看 AI 有沒有交出完整答案,還不足以判斷工作做得好不好。
圖:整理前述使用者的回報;找檔案要核對清單,查資料還得確認引用內容與日期,兩種工作需要檢查的地方不同。
改程式時,為什麼有人用 Medium,有人改用 High?
另一位 Reddit 使用者則想知道,Haiku 能不能接手日常寫程式的工作,以及該把推理設在哪個程度。
他從一個同時包含 Rust 程式與舊腳本的實際專案,挑出修正錯誤、審查程式和實作功能等任務,讓不同模型比較,並把測試經過貼在 Reddit。
其中一題,是請 Agent 在同一個專案裡,把一部分程式邏輯移到另一種程式語言的程式裡,修改後還要遵守專案原有的寫法與慣例。
他在模型開始工作前,就先寫好標準答案與測試,完成後再用這些資料檢查修改是否正確。
第一輪,Haiku Medium 完成修改、通過測試,也遵守了專案慣例,總共呼叫模型 29 次,約 0.08 美元。
Sonnet Medium 做同一題,呼叫了 30 次、約 1.68 美元;Haiku High 也做對了,卻用了 385 次、約 1.03 美元。
在這一題,多想一些沒有多帶來成果。
但原作者後來在同一討論串追加了另一輪測試,讓 Haiku 和 Sonnet 處理 3 項更複雜的程式開發工作,再用預先準備的測試評分。
這輪共執行 16 次,有 15 次通過,唯一失敗的是 Haiku Medium 遇到描述含糊的錯誤時,修改範圍超過需要。
改用 High 後,那個問題解決了,而且在最難的一題裡,處理步驟反而減少。
繼續開到 Max,卻沒有再增加成果,同一項工作的費用反而從 High 的約 0.21 美元,升到約 1.50 美元。
原作者在追加回覆中提出的分工,是讓 Opus 規劃與分派工作、Haiku High 實作,需求模糊時交給 Sonnet Low,必要時再請 Codex 裡的另一家模型複查。
他在另一則回覆裡也說明了交接的麻煩:原本由 Opus 把工作送到 Codex 的模型,得先整理專案背景、傳過去,再拿回結果檢查。
改用能直接讀取同一份專案的 Haiku,就讓他有了把日常修改留在 Claude 裡完成的想法。
所以他調整模型時,一起考慮了做不做得對、用了多少步驟,以及工作要怎麼交接。
放到評比圖裡,Haiku 的價格有多低?
個別專案可以看工作細節,如果想知道 Haiku 跟其他模型的大致位置,可以再看 Artificial Analysis 的比較。
下圖保留 10 月 16 日的資料:越往左,完成評測任務的平均成本越低;越往上,Intelligence Index 綜合能力指數越高。
這個指數綜合了程式開發、Agent 與知識推理等評測,可以對照整體成績,但要判斷查資料會不會出錯,仍得看前面那種具體工作。
圖中的成本會計入輸入、快取、模型思考與答案用掉的 Token,也就是模型處理文字的計量單位,所以可以比較這組評測完成一項工作花多少錢。
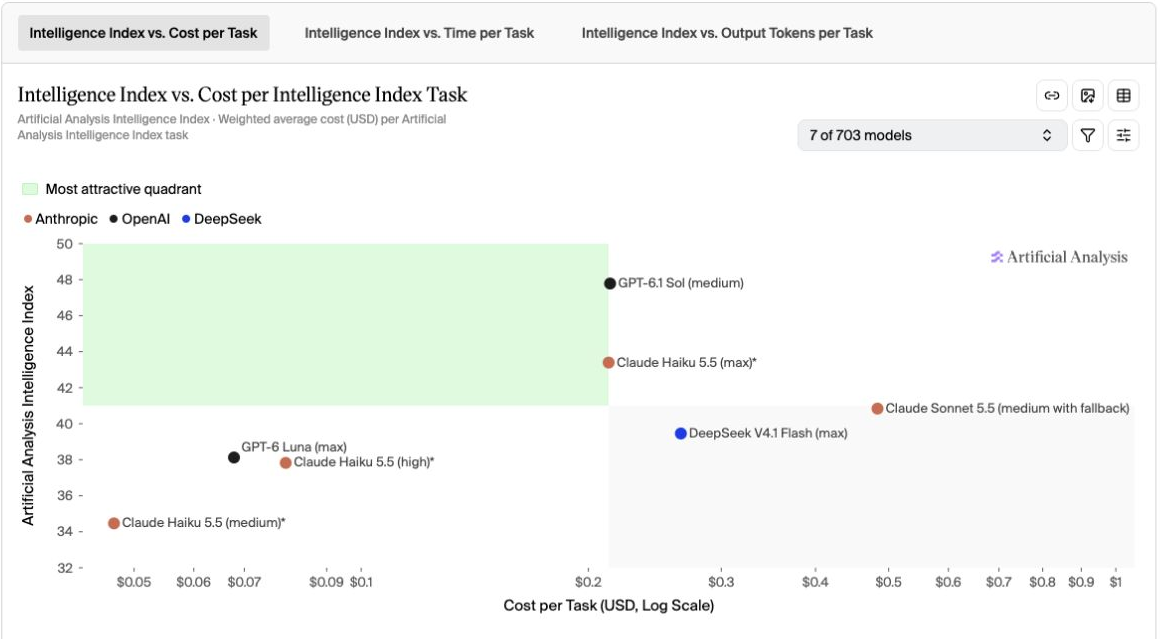
圖:先找左下方的 Haiku High 與 Luna Max,再看右上方的 Haiku Max 與 Sol Medium;同一張圖可以比較相近成績要花多少錢,也能比較相近花費得到什麼成績。
圖表來自 Artificial Analysis 的 7 組模型比較,使用 2026 年 10 月 16 日、Intelligence Index v4.3.2 與各原廠 API 的快照。
Haiku High 和 GPT-6 Luna Max 都約 38 分,平均任務成本分別為 0.08 與 0.07 美元,在這個成績區間,Luna 還稍微便宜一些。
再把 Haiku 開到 Max,成績約 43 分,成本升到約 0.21 美元;相同成本附近,GPT-6.1 Sol Medium 約 48 分。
若只看 Terminal-Bench 4.0 的終端機工作評測,Haiku Max 通過率約 33%,Sol Medium 約 48%。
換句話說,願意花到這個金額時,還有其他成績較高的選項可以比較。
同廠的 Sonnet 5.5 Medium 約 41 分、0.48 美元,圖上保留了它的完整設定「with fallback」,包含安全拒答時的備援處理。
開放權重的 DeepSeek V4.1 Flash Max 則約 39 分、0.27 美元,這裡算的是它的 API 費用。
DeepSeek 的官方權重採 MIT 授權,若要自行架設,機器與維運得另外算,不能直接沿用圖上的 API 成本。
推理開得越高,也可能等得越久
前面的程式修改回報,已經出現 Max 花更多錢卻沒有增加成果的情況,評比圖也能看見提高推理的代價。
Haiku Medium 約 34 分、每個評測任務 0.05 美元,High 約 38 分、0.08 美元,Max 約 43 分、0.21 美元。
從 Medium 到 Max,平均成本變成約 4.2 倍,而模型開始交回答案之前的等待,也明顯拉長。
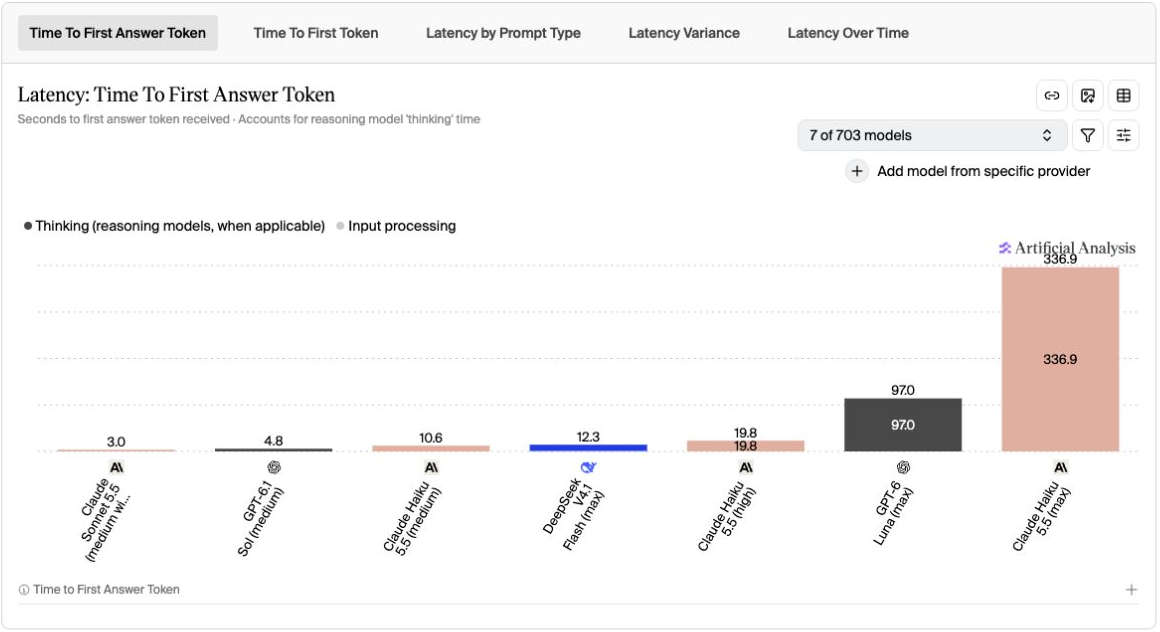
圖:Haiku Medium 約 10.6 秒、High 約 19.8 秒,Max 約 336.9 秒才開始收到答案;同為 10 月 16 日的原廠 API 測量,時間包含模型思考,單位為秒。
圖上還有一組值得一起看:成績同樣約 38 分的 Haiku High 與 Luna Max,分別約等 19.8 秒與 97 秒才開始收到答案。
如果你正在電腦前等 Agent 回覆,這個差距就很容易感受到。
不過,這裡量的是開始收到答案的時間,整項工作還會受到後續搜尋、工具操作與修改影響,不能直接當成全部完成的時間。
各家的 High、Max 也是各自的設定名稱,實際投入多少思考,得看結果與用量,不能只對照名稱。
最後還是要回到:你準備交給它什麼工作?
從這些回報來看,Haiku 5.5 值得留意的用途,是有清楚範圍、成果也容易核對的工作,例如找出要修改的程式檔案。
前面的使用者在這件事上,用較低費用拿到了接近其他模型的結果;但查詢最新規則、核對文章內容時,他仍把工作交回 Opus。
想多花一點錢改善結果,也要看增加的推理有沒有用在需要的地方:另一個程式專案從 Medium 改成 High 解決了問題,繼續開到 Max 卻沒有多得到成果。
因此,如果你正在考慮讓 Haiku 接手現有工作,這些案例能提供的判斷方式,是拿同一份工作比較交回的結果、實際費用和完成時間。
少付一點錢,結果又能通過原本的檢查,才真的省到了;如果還得重查、重改,那些時間也要算進去。